新开一个坑,纯粹的人类写作来讲解deep learning audio,顺序和内容参考 Deep Learning Audio Course – AI Masters。
这一部分会讲解一下语音模型的用途,语音任务,和语音输入具体长什么样子。
语音模型的用途和任务
目前语音模型在我们的生活中有比较广泛的运用,包括Transcription(会议转录、字幕),voice agent(Siri,Alexa,车载助手),Customer Service(美国有很多医疗/零售的电话agent),Voice Cloning(变声期,朗读,游戏/视频ai配音)。
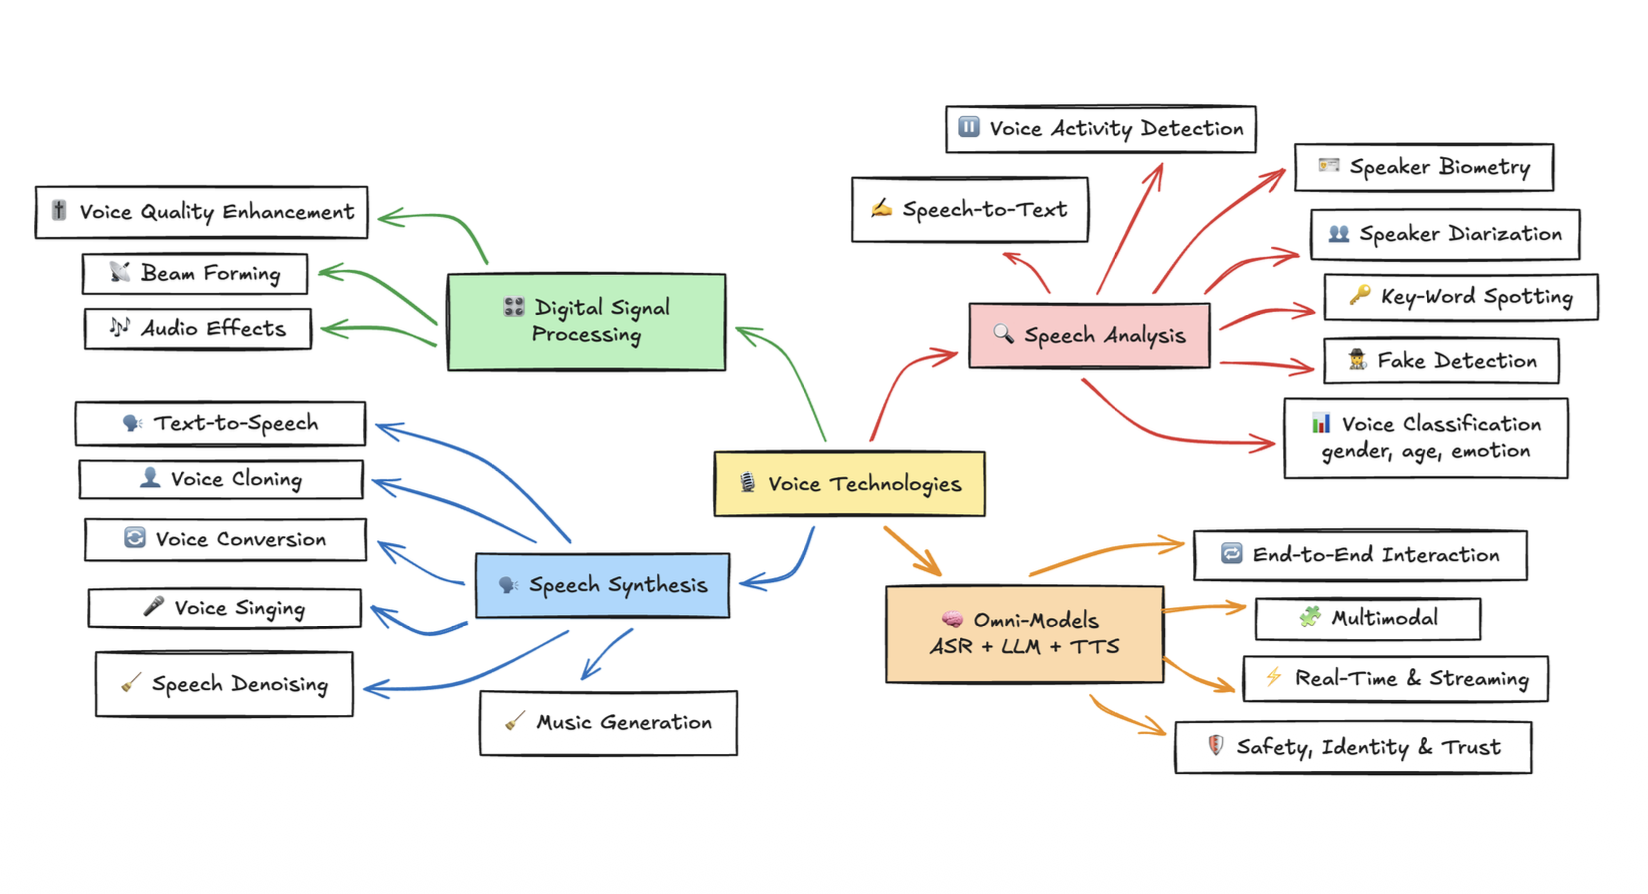
从任务来讲,一般是分成几类任务:语音分析,语音合成,和其他任务。具体来讲
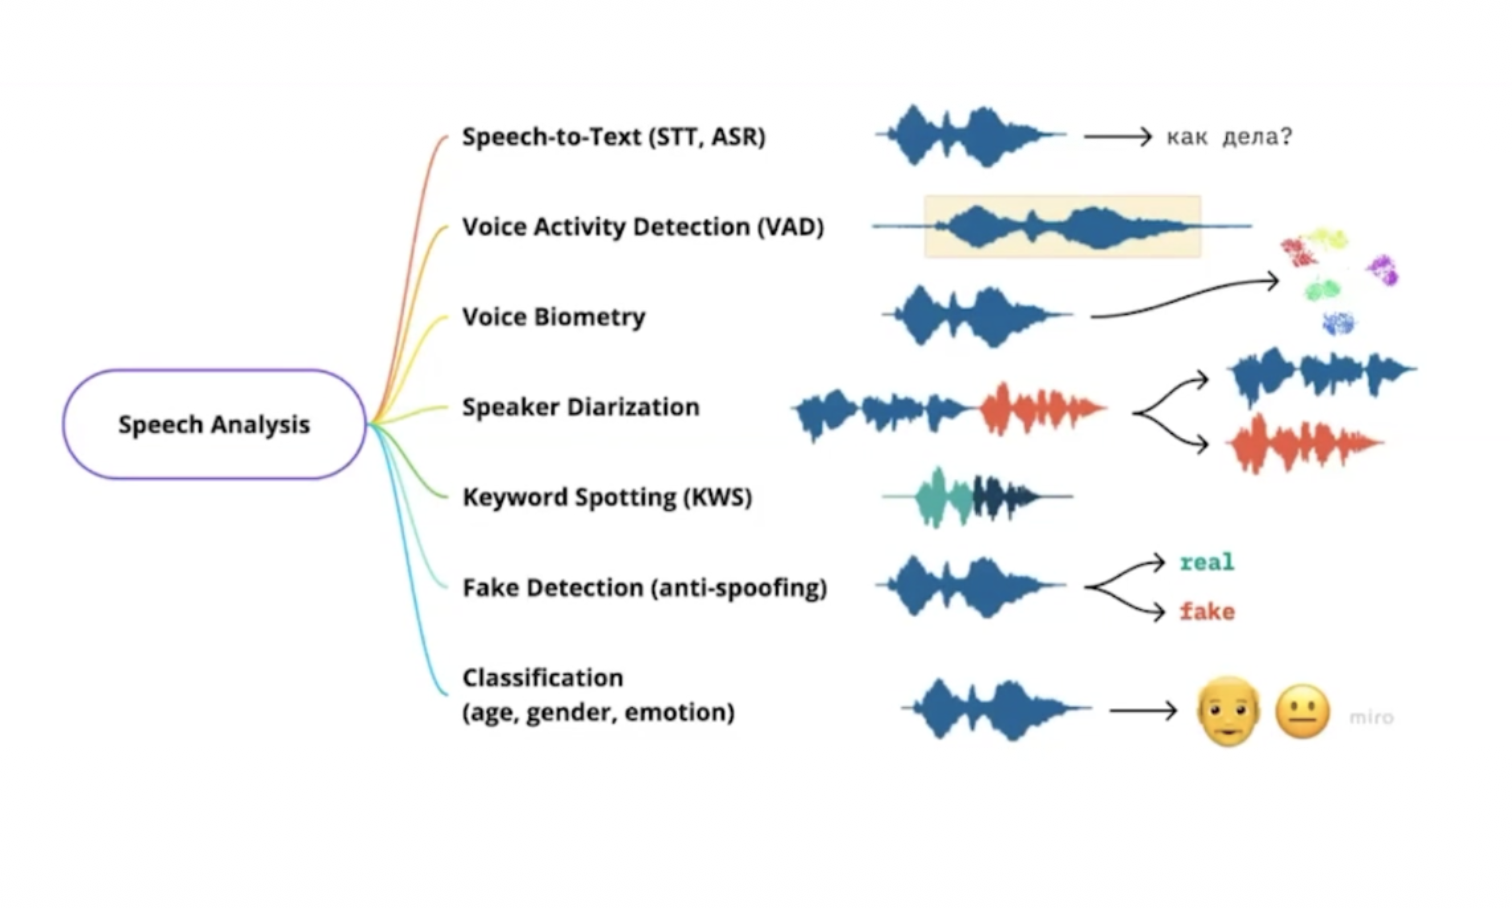
- 语音分析(Speech Analysis)
- ASR / Speech-to-Text,经典的语音识别任务,经典的pattern是raw audio → spectrogram → acoustic model → language model
- VAD:哪里有人说话,一般用在语音助手唤醒和语音助手交互的打断等等
- Speaker Recognition / Diarization:siri的唤醒会有speaker identification
- Keyword Spotting:检查keywords,用于语音助手
- Fake Detection:识别是否是ai生成的语音
- emotion / age / gender classification
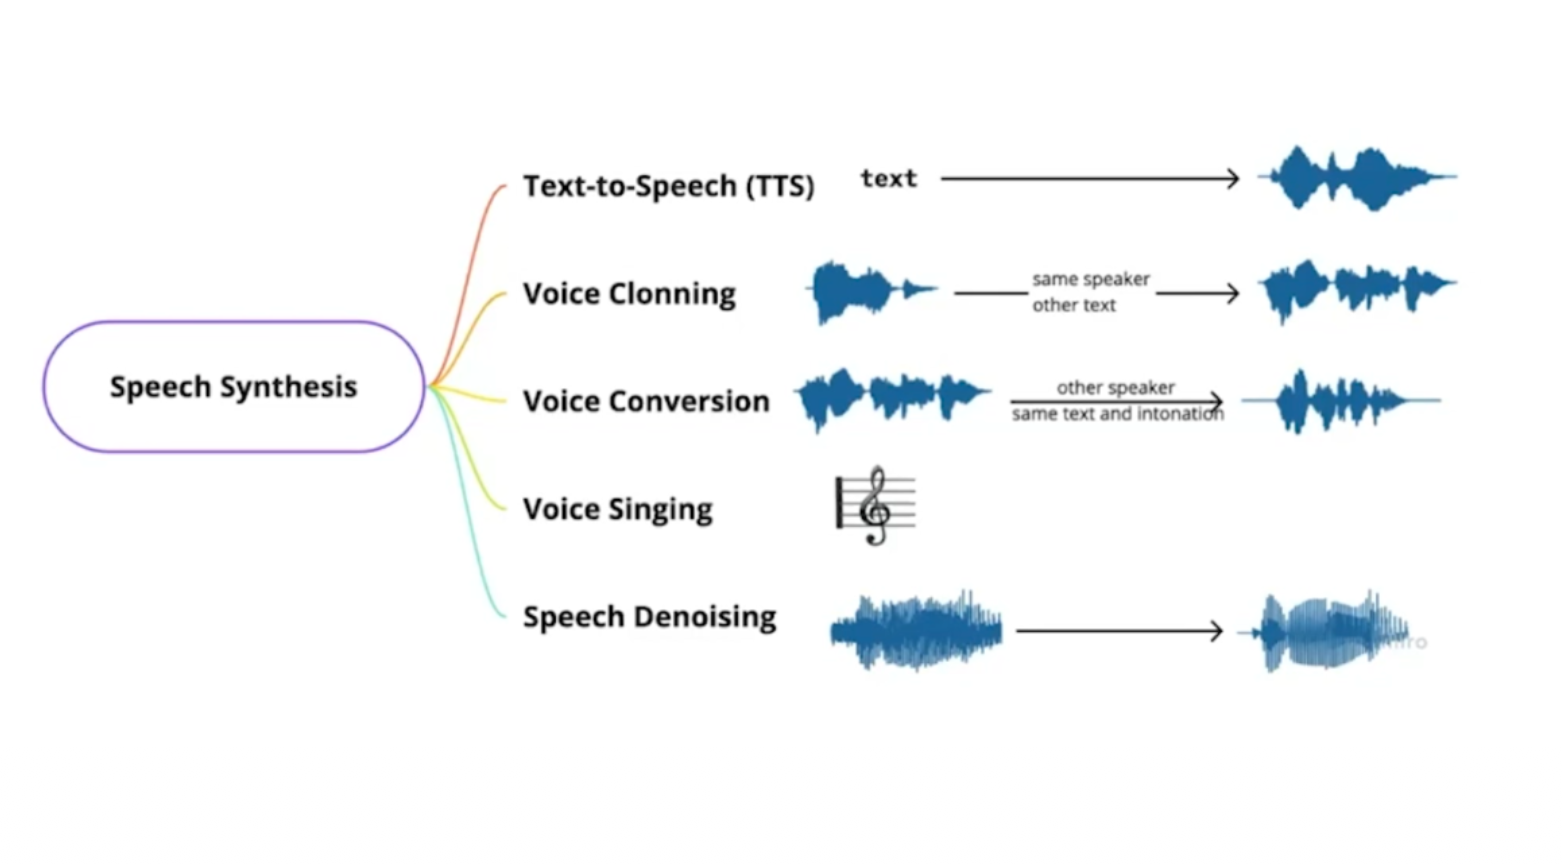
- 语音合成(Speech Synthesis)
- TTS:语音合成
- Voice Cloning:根据reference audio做声音克隆,变声器/ai配音等
- Voice Conversion:保留其他东西,只把一个人的声音换成别人的
- Singing:字面意思
- Denoising:语音输入降噪,比如discord的krisp降噪模型
- 更大的系统
- audio-to-audio conversation
- multimodal
- realtime streaming
声音的本质
在物理上,声音本质上是机械波。声音是空气的压缩和稀疏,在空气中把同一个位置的压力随时间/位置画出来,就得到 waveform。Waveform 不是声音本身,而是一个位置对声压随时间变化的测量。
人耳朵里的耳蜗是一种频谱分析器,耳蜗像是蜗牛的壳一样卷起来,不同位置有不同的机械特性导致会根据不同频率震动。然后不同位置的毛细胞会把机械振动转换成神经信号,通过神经传给大脑。
现实中声音是连续的,但是我们不可能测量/保存所有数据点,所以只能每隔一段时间做采样。假如每隔1/t s做采样,sample rate就是 t hz。所以一段单声道音频解码后的本质就是一连串长度为 n 的数字,n = sample rate × duration;多声道音频则每个声道都有这样一串数字。
不同任务需要保留不同的最高频率。人耳的听觉范围通常可以到约 20 kHz,但 ASR 不一定需要保留完整的可听频段,因此经常使用 16,000 Hz 的采样率,对应约 8 kHz 以下的频率。如果要保留接近 20 kHz 的声音,就需要更高的采样率。Nyquist theorem 讲的是,对于带限信号,采样率需要高于最高频率的 2 倍(fs > 2 f_max)。原理是如果我只看到一些离散的 sample points,我怎么知道原来的连续波到底长什么样?因为采样之后,不同的连续频率可能产生完全相同的 samples。采样率必须足够高,才能避免这种歧义。
我们知道了声音可以用waveform表示,那么相同的waveform可以用不同格式来存储。存储原始 PCM 数据、没有压缩的常见格式是 WAV / AIFF(它们是容器格式,也可以容纳其他编码),经常能在语音深度学习里看见。FLAC / ALAC是无损压缩格式,可以恢复成原始的list,MP3 / AAC / Opus是有损压缩,尽量删除人类不敏感的部分。
傅立叶变换
我们已经有了一个list,来表达不同时间段声波的强度,但是我们其实会更关心这个声音里面有哪些频率?每个频率有多强?一般来说,自然界的声音都是多个波的叠加,如果单纯分析waveform本身很难看出来。因此,我们会做傅立叶变换,拿不同 frequency 的“标准波”去和我们的原始waveform做匹配,看看匹配程度。比如说一段复杂的音频,傅立叶变换能告诉我们500hz强不强,501hz强不强等等。
建议参考以下视频,以后可以考虑写一篇文章详细解释一下: https://www.bilibili.com/video/BV1eUHjzgEAd https://www.bilibili.com/video/BV1pW411J7s8
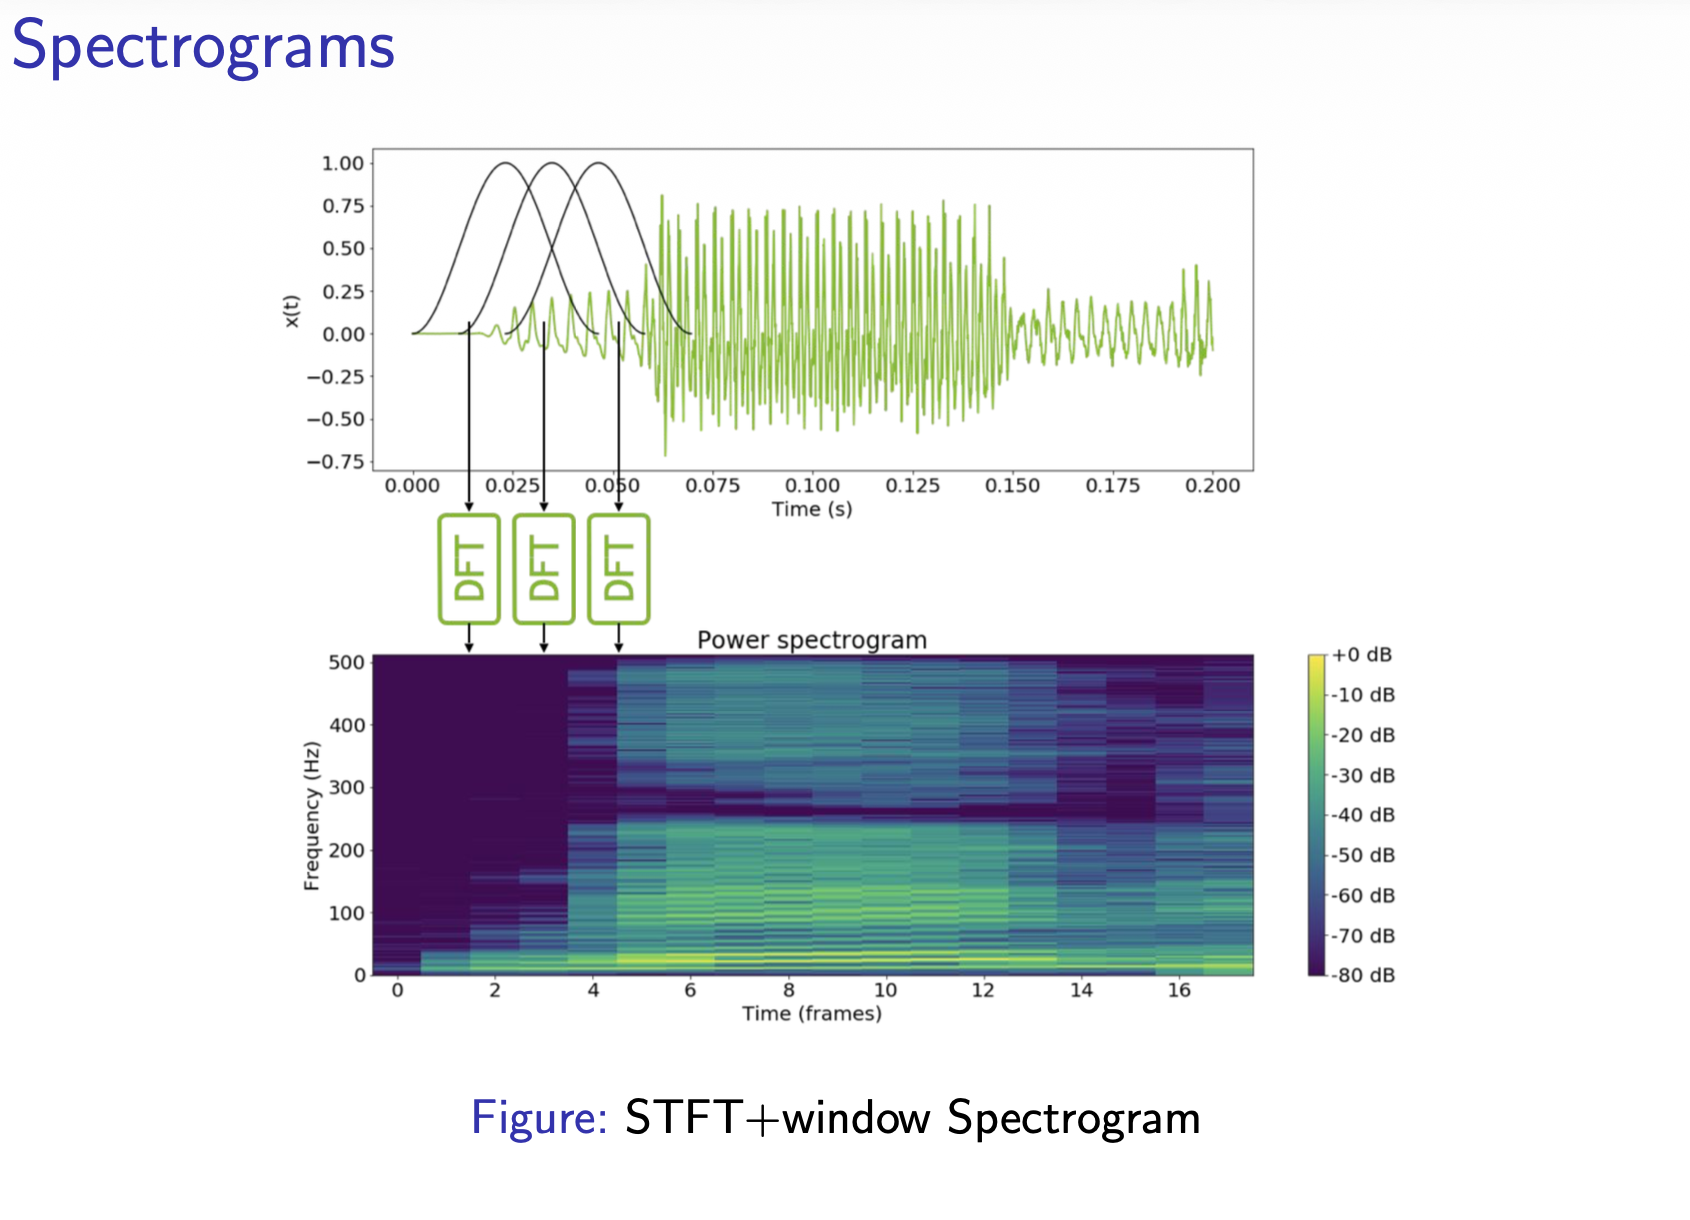
虽然傅立叶变换能告诉这一段声音里都有什么频率,但是我们不知道这些 frequency 是什么时候出现的,原因是naive的傅立叶变换把 time 维度丢掉了。因此,我们需要把时间维度加上。我们下一步会把 waveform 切成很多短 window,每一个window单独做傅立叶变换,得到一个f(x,t),这就是 STFT,画出来就是 spectrogram。
Mel spectrogram 和 MFCC
普通spectrogram y轴是线性排列的,但是人类的耳蜗对频率的感知不是。Mel是把 frequency 轴从物理世界的Hz重新映射成更接近人耳分辨率的表示,intuition是既然语音任务最终与人类语音/听觉有关,那就把表示能力更多分配到人耳更敏感的频率区域。人耳在低频对频率差异比较敏感,因此需要更细的 resolution。但是在高频的时候,人耳对相同 Hz 差异没那么敏感,因此可以压缩。
MFCC 是在 Mel spectrogram 上继续做一次变换,把频谱压缩成更紧凑、偏向描述声道形状的特征。首先我们会先做log,因为人类对响度的感知近似 logarithmic,同时能把source × filter 变成加法。之后我们会做dct,就是用多个cosine函数去拟合原来的log mel。它的含义是把信息重新排列,让“平滑的大尺度频谱形状”集中到前几个 coefficient 中。
总的来说,mel spectrogram表达的是什么时候有哪些更接近人耳尺度的 frequency bands。再经过log + DCT + truncate后,变成用少量 coefficients 概括每一帧的 spectral shape / envelope。
采样率与音频格式可参考 MDN 的数字音频概念;MFCC 的计算可参考 TorchAudio 文档。