这一篇文章主要讲解asr模型 part I,但是我的讲解会默认读者大概对cv/nlp有一定的了解,所以有一定的门槛。asr现在已经广泛运用在各个领域中,它的核心作用是把语音转换成文字,主要应用场景包括以下类别:
| 场景 | 典型例子 | ASR 的作用 |
|---|---|---|
| 语音助手 / Voice Agent | Siri、车载助手、AI 客服 | 把用户说话转成文本,交给 LLM/NLU |
| 会议 / 通话转写 | Zoom、Teams、会议纪要 | 实时或离线生成 transcript |
| 字幕 | YouTube、直播、课程 | 自动生成实时字幕 / Closed Caption |
| 客服 Call Center | 电话客服、销售电话 | 全量转写,再做质检、摘要、意图分析 |
| 语音输入 | 手机 dictation、语音搜索 | 用说话替代键盘输入 |
| 音视频内容检索 | Podcast、采访、视频库 | 转成文本后建立搜索索引 |
| 医疗 / 法律等专业记录 | 医生口述病历、庭审记录 | 专业词汇 transcription |
| 无障碍 | 听障实时字幕 | 将环境中的语音实时显示为文字 |
| 多模态 / Speech LLM | Qwen-Omni、GPT 类语音系统 | ASR 作为 speech understanding 的前端或中间能力 |
ASR 的应用与系统形态
按音频是否完整可用,可以区分两种 ASR 运行方式:
- offline asr:已经有完整音频,比如 Podcast字幕/视频字幕生成,重点通常是正确性,对延迟没那么敏感。
- streaming asr:语音一边输入,模型一边输出,常见于实时字幕/电话客服等,除了正确性还关注latency和continuity。
Full-duplex speech interaction 是更上层的交互形态:系统需要在输出语音的同时持续听用户,并处理 interruption、barge-in 等等。ASR / speech understanding 是其中的一部分,不是与 offline / streaming 并列的第三种 ASR。
如何评价 ASR
在讲解具体的原理和模型之前,我们先了解一下应该如何正确的evaluate一个asr模型。模型层面除了正确性和 robustness,也常关注 latency / RTF(处理耗时与音频时长之比)、memory、streamability 和长音频能力;系统层面还需要评估整体 throughput 和端到端 latency。正确性的metric如下:
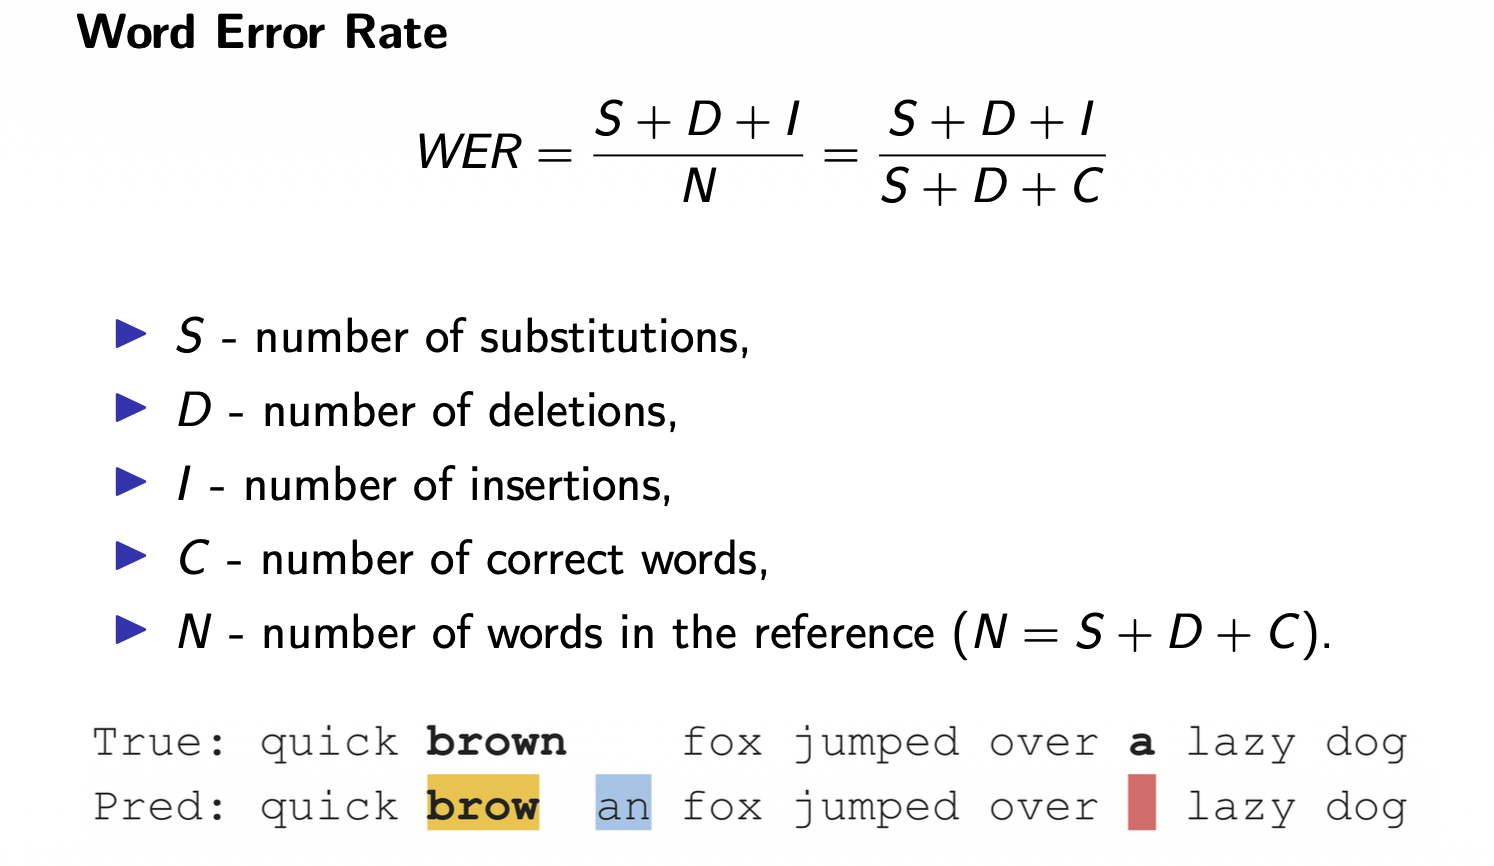
Levenshtein Distance(编辑距离):给定两个序列 a 和 b (一般是predicted value和ground truth),最少需要多少次编辑,才能把 a 变成 b。 允许三种操作:替换,插入和删除,且每一次的cost是1。这好像也是一道经典的leetcode dp题了。
wer就是在lev dist的基础上,做一次normalization。cer也类似,只是把 Levenshtein distance的基本单位从word换成character。英文等有明确 word boundary 的语言通常用 WER,中文、日文等 word boundary 不明确的语言通常用 CER。
常见 ASR Dataset
| Dataset | 特点 | 主要用途 |
|---|---|---|
| LibriSpeech | 英文 audiobook、较干净 | 经典 benchmark |
| Common Voice | crowdsourced、多语言、短句 | multilingual |
| GigaSpeech | podcast / YouTube / spontaneous speech | 更接近真实环境 |
| Earnings-22 | 财报电话 | accent / business speech |
| AMI | meeting | spontaneous meeting ASR |
| FLEURS | 102 languages | multilingual / zero-shot evaluation |
ASR 仍然面临的挑战
即使今天 WER 已经很低了,现代 ASR 仍然有很多挑战。因为语言转文字仍然有以下的痛点:
声学层面的歧义,也就是同一句话的声音表现可以差很多,或者不同内容听起来可能很像。
- 噪声:背景音乐、街道声、键盘声会干扰语音信号。
- 口音:不同地区、不同母语背景的人,对同一个词的发音可能差异很大。
- 多人重叠说话:两个人同时讲话时,模型需要从混合声音中分离并识别不同说话人的内容。
- 远场语音:说话人离麦克风较远时,会出现音量衰减、混响和回声,使语音特征变得模糊。
语言层面的歧义也就是即使声音已经听得比较清楚,也不一定能仅靠发音确定正确文字。
- 同音词 / 近音词:多个词可能发音相同或非常接近,需要结合上下文判断。
- 人名、地名、专有名词:这些词往往少见,模型可能没有见过。
- 领域术语:医疗、法律、金融、技术等领域包含大量低频专业词汇,仅靠声学信息很难识别正确。
长音频与上下文依赖问题,也就是当前语音的正确识别往往依赖更长范围的上下文。
- 前文影响后文:同一个发音,在不同上下文里可能对应不同词。
- 标点与分段:ASR 不只是识别词,还要判断哪里停顿、哪里断句、哪里加标点。
- 说话人轮次:在会议、对话中,还需要判断什么时候换了一个说话人。
流式识别约束,也就是模型必须在语音还未结束时就开始输出结果。
- 未来音频不可见:当前时刻只能使用已经收到的声音,不能依赖后面的内容。
- 延迟与准确率权衡:等得越久,模型看到的上下文越完整,通常越准确;但等待时间越长,实时性越差。
理解 ASR 的五个角度
为了让大家更好的理解asr模型,我会从5个角度来讲解asr模型的发展以及其背后思想的变化。原本的ai audio master课件我个人感觉有点跳跃,不能很好的讲解asr的来龙去脉,所以接下来我们会用我和gpt battle出来的这个模型来讲解。第一篇文章会cover representation,下一篇会继续讲解其他的部分:
ASR = Representation + Alignment + Language + Knowledge + Deployment
| 维度 | 核心问题 |
|---|---|
| Representation | 声音应该怎样表示? |
| Alignment | 连续声音怎样对应离散文字? |
| Language | 哪个文字序列更合理? |
| Knowledge | 模型的这些能力从哪里学来? |
| Deployment | 模型要在什么现实约束下运行? |
Representation:从人工特征到学习表征
先回顾一下,上一篇文章提到了我们通过采样声波数字化后变成大量采样点,变成一个很长的list。早期 ASR 往往依赖人工设计的特征,比如把waveform 变成 spectrogram 之后再变成MFCC。(补充一下,在语音信号处理中,另一个常用的representation Fbank(Filterbank 特征)指的就是 Log-Mel 谱(对数梅尔谱))
这里我们其实已经提前加入了很多关于 speech 的知识,MFCC 实际上是在试图保留这个人发了什么音同时减少具体频谱里各种不太重要的细节,是典型的 hand-crafted representation。当然,虽然现在mfcc不是主流了,但是它反映了我们对好的asr的定义:一个好的 ASR representation 应该保留 linguistic information的同时丢掉 nuisance information(比如麦克风噪音,背景杂音等等)。随着深度学习的发展,就像cv一样我们逐渐开始希望模型自己能学习到一些hidden representation而不是继续用手工的专家表征。
CNN 和 RNN:不同的 inductive bias
这里不把模型发展写成 CNN → RNN/LSTM → Transformer 的线性历史。RNN/LSTM 在 ASR 中的广泛应用早于 QuartzNet 这类纯 CNN 模型,例如 2014 年的 Deep Speech 已经使用 RNN。CNN 擅长局部声学结构,RNN/LSTM 擅长沿时间积累上下文,两种 inductive bias 也常被组合使用。
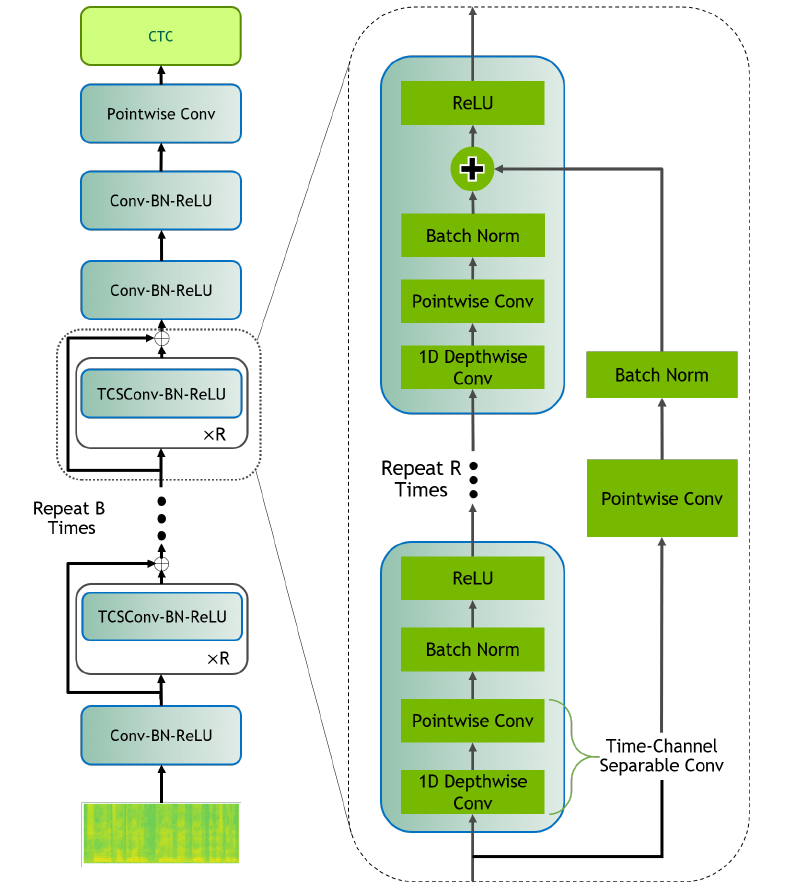
CNN 很自然的被引进了,因为 speech 有明显局部结构,经典的纯cnn based encoder的asr模型架构是英伟达的 QuartzNet。我们可以注意到它只在时间维度上做卷积,并且输入是Mel-scale Spectrogram而不是mfcc。
RNN、LSTM 和 Transformer:时间上下文
从时间上下文的角度看,speech 或者 waveform 本质是一串长 sequence,RNN / LSTM 通过递归状态建模它。后来 Transformer 用 self-attention 建模时间点之间的关系,在非流式、全局注意力设置下,每个时间点可以直接看整个序列。naive的RNN/LSTM只能看到当前声音和之前的信息,所以也有了像BiLSTM这种双向且长上下文能力的模型结构。但是rnn类的模型有两大难题:1. sequential dependency,模型需要计算前一个state才能继续计算下一个state,因此 training 很难沿时间维完全并行,对当代gpu的计算架构非常不友好。相比之下,transformer可以同时做大规模的并行计算,这正是现代gpu擅长的。2. 信息传播路径很长,从h1到h1000要经过1000次,但是transformer允许一个序列内直接建立任意两个时间点之间的关系。
虽然 NLP 很快接受 Transformer,但 speech representation 没有直接停在 vanilla Transformer。原因是audio 和 text 有一个非常大的区别是Text 已经高度压缩,一句话可能只有20个token。但是Audio 非常 dense,一分钟可能有6000frames,这对于计算复杂度是O(T^2)的vanilla Transformer非常不友好。
Conformer:结合局部结构与全局上下文
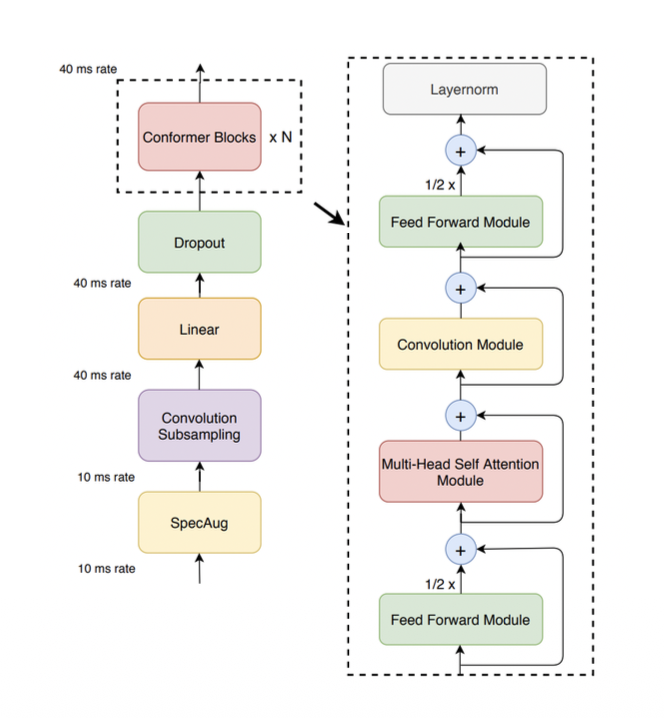
于是一个非常重要的改进 Conformer 出现了,这是 ASR 最重要的 Transformer variant 之一。它结合了Transformer + CNN。设计这个架构的原理是,我们发现 Speech 同时具有 local acoustic structure 和 global context:比如几十毫秒尺度的formant,phoneme transition,transient等等 是强 local pattern;而:word,sentence,long-range context又需要 global modeling。
自监督表征与声学前端
与架构设计并行的另一条路线是自监督学习。Conformer 和 wav2vec 2.0 都发表于 2020 年,但关注的问题不同:前者关注架构,后者关注如何从无标注音频学习表征。监督式 ASR 表征学习依赖语音文本对,而 wav2vec 2.0 这类方法提出:大量只有 audio only数据也可以先学习 representation,就是self-supervised representation。模型可以通过类nlp的 masked prediction / contrastive-style objective 学到,之后再用少量 labeled ASR data fine-tune。所以 representation learning 开始和具体 ASR label 解耦。
但现代模型并没有完全抛弃人工 representation。Whisper 仍然使用 log-Mel spectrogram,而不是直接 raw waveform。越往后,模型承担的 representation learning 越多,但一个便宜、稳定、带有合理 inductive bias 的 acoustic frontend 依然可能非常有价值。 2026 年还有很多 ASR 模型使用 Mel frontend。
效率与部署驱动的架构:FastConformer
Conformer 很强,但是O(T^2)的计算还是非常昂贵,2023 年的 FastConformer 则从效率和部署约束出发改进架构。他的思想就是减少后续网络需要处理的时间点,FastConformer 创新性地采用了 8 倍深度可分离卷积下采样,将输入特征的序列长度直接缩短,大幅减少了后续Self-Attention层的计算负担,并探索了类似 Longformer 的 local 与全局 Token 结合的注意力机制,用于长音频的高效建模。
跨模态的相互影响与架构选择
这里也要讲个题外话,就是不同模态representation的发展是互相关联的。早期cv,audio,nlp三者各自处理自己的模态。因为NLP是离散 token,CV是二维像素,ASR是连续 waveform / spectrogram。 但是后续ASR 明显受到 CV 影响,因为spectrogram 本身就是一个二维 time-frequency map,所以很自然地借用了 CV 里popular的CNN。前面也提到cnn的优点是local pattern,这和语音里的特点非常符合。所以 QuartzNet、早期 CNN acoustic model,本质上和 CV 的 feature hierarchy 很像。
要说明的一点是cnn和rnn并非是谁取代了谁,而更像是从不同的维度来尝试建模表现。随着nlp的兴起,NLP 和 ASR 都是 sequence,于是 RNN/LSTM 在两边都很自然。他们区别主要是输入:NLP 输入已经是离散 token,ASR 输入还是密集连续 frame。
Transformer 是三大模态真正开始统一的节点,它最先在 NLP 爆发,但很快被 CV 和 speech 接受。因为它给出一个非常通用的抽象:一旦你能把任何模态变成 vector sequence,后面都可以用self attention。于是出现了NLP:BERT / GPT,CV:ViT,Speech:Transformer encoder / Conformer / Whisper。这个阶段反映的思想是所有模态都可以先 tokenize/patchify/encode 成一串向量,再做 context modeling。
纯 Transformer 从 NLP 借来后有一个问题是speech 很依赖局部结构。所以 Conformer 加回局部信息的cnn,这其实和 CV 里的很多 hybrid architecture 思想类似。不能说 Conformer 在 audio 里取代了 Transformer,更准确的是Conformer 是 Transformer 在 speech/audio 场景下的一种重要 specialization。
Transformer 与 Conformer 架构并存,而二者都可以进一步设计成 streaming / non-streaming 版本;streaming 是运行约束,不是与它们并列的架构类别。用 convolution 显式建模局部声学结构,所以在 dedicated ASR、streaming ASR 里很有优势。但是纯 Transformer 更通用、更容易 scale 尤其在 speech encoder + LLM、multimodal foundation model 里,统一 Transformer stack 往往更方便。不同 deployment 场景下目标不同,edge、streaming、高吞吐、large-scale multimodal 并没有同一个最优 architecture。