在上一篇文章里,我们提出了一个理解 ASR 的框架:
ASR = Representation + Alignment + Language + Knowledge + Deployment
这一篇继续讲 Alignment:连续的声音,怎样对应离散的文字?建议先读上一篇关于语音表征的讨论,再来看这个问题。
Alignment:声音与文字为什么对不齐?
一句话可能有上千个声学帧,却只有几十个字符或 subword token。每个音持续多久、文字应该在哪一帧出现,训练数据通常没有直接告诉我们。同一句话说快一点或慢一点,对齐关系也会变化。
这里的 alignment 主要指识别模型内部连接声学时间与输出符号的机制。它和最终展示给用户的词级时间戳有关,但不是同一件事:能识别正确文字,不代表已经获得准确的词边界。
DTW:允许时间轴被拉伸和压缩
早期孤立词识别的一条路线,是把输入语音的声学特征与预先记录的词模板比较,选择最相似的模板。DTW(Dynamic Time Warping)用动态规划处理说话速度不同造成的时间错位。
假设两段特征序列分别有 m 帧和 n 帧,先构建 m × n 的距离矩阵,每个位置表示两个特征向量的距离。然后在边界、单调性和步长约束下,寻找从起点到终点累计代价最小的路径。它允许一个序列的局部片段对应另一个序列中更多或更少的帧,相当于拉伸或压缩时间轴。
要注意,DTW 直接对齐的是两段声学特征序列,并不是直接把音频帧映射到字符。词标签由模板提供;单调性表示两段声音的时间顺序不能被打乱。VQ(Vector Quantization)可以用于压缩或离散化特征,但不是 DTW 的必要组成部分。
DTW 通常选择一条最优路径,没有对其他可能路径的概率做求和。面对模糊的音素边界,这就引出了另一种建模方式:把 alignment 当成需要推断的 latent variable(隐变量)。
HMM:把对齐路径概率化
HMM(Hidden Markov Model)是传统 ASR 的核心模型之一。用一个简化例子来看,cat 可以写成音素 /k/、/æ/、/t/。我们知道顺序,但不知道各音素占多少帧。
先把每个音素画成一个状态,允许自循环和向下一状态转移:
/k/ → /æ/ → /t/
 ↺     ↺     ↺
这样,下面两条路径都能解释同样的八帧声音:
路径 A:k, k, æ, æ, æ, t, t, t
路径 B:k, æ, æ, æ, æ, t, t, t
路径 A 把 x₁、x₂ 分配给 /k/,x₃ 到 x₅ 分配给 /æ/,x₆ 到 x₈ 分配给 /t/;路径 B 则给 /k/ 更短的持续时间。实际系统往往为一个音素设置多个状态,并使用上下文相关、绑定的状态,这里的一音素一状态只是教学简化。
训练时,Forward-Backward 计算隐藏状态及转移的后验,Baum-Welch / EM 据此更新参数,而不是预先固定某条路径。解码时,Viterbi 寻找分数最高的路径;真实识别还会结合词典和语言模型。可以用一句话记住经典做法:训练时对路径求和,Viterbi 解码时对路径取最大值。这不是所有 HMM 训练与解码方案的统一规则。
从 GMM-HMM 到 DNN-HMM
神经网络进入 ASR 后,并没有立刻抛弃 HMM。DNN-HMM改变的是声学打分方式,对齐和状态转移框架仍由 HMM 提供。
GMM 建模的是状态条件下的声学观测似然 p(xₜ | qₜ)。典型 hybrid DNN 则输出状态后验 P(qₜ | x),输入可以包含多帧上下文。解码时通过 Bayes 关系,用后验除以状态先验 P(qₜ),得到与声学似然成比例的分数。因此不能简单说“DNN 直接接替 GMM 输出同一种概率”。
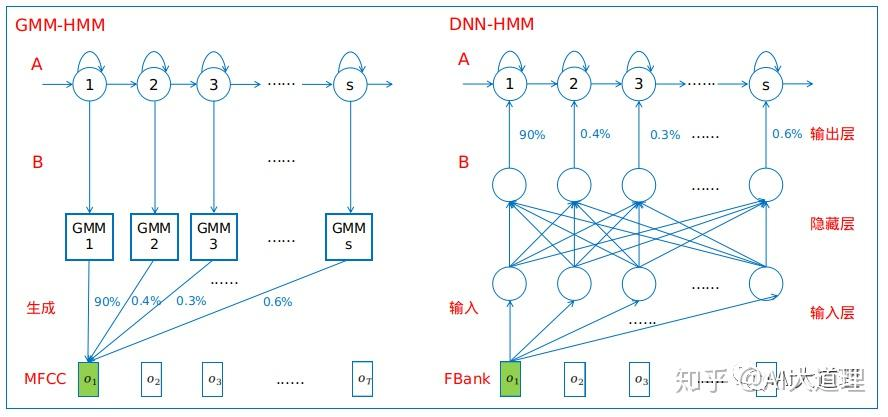
原稿配图,保留原有水印。图中的 MFCC / FBank 是示例前端选择,不是两种框架必须使用的特征。
Deep Learning 在这条路线中首先改变了 Representation / Acoustic Model,而不是直接取消 Alignment。
CTC:对所有能生成目标文本的路径求和
端到端 ASR 希望减少对手工音素状态和发音词典的依赖,但仍然要回答:1000 个声学帧怎样对应 20 个文字 token?CTC(Connectionist Temporal Classification,2006)提供了一个不需要帧级标注的训练目标。
CTC 给每个编码器时间步预测词表中的 token 或 blank。collapse 操作要按顺序做两件事:先合并连续重复符号,再删除 blank。
c c _ a a _ t → c _ a _ t → catblank 不只是“静音标签”。它表示这个时间步不输出文字,还能分隔相邻的相同字符:l _ l 会保留两个 l,而 l l 只会保留一个。
设 X 为音频,Y 为目标文本,A 为逐帧路径,B 为 collapse 映射,那么:
P(Y | X) = Σ over A with B(A) = Y of P(A | X)
P(A | X) = ∏ₜ P(aₜ | X)
CTC loss = −log P(Y | X)
动态规划高效地完成这个求和。输出单位可以是字符、subword,也可以是音素;CTC 并不强制只能输出文字。它既定义了一种单调对齐机制,也给出了对应的可微 loss。
Conditional independence 不等于没有声学上下文
CTC 的限制是:给定 X 后,路径上各时间步的输出概率按乘积因子化,没有显式条件于先前输出的文字。它不像自回归 decoder 那样直接建模 token 之间的依赖,因此常结合外部语言模型。
但 P(aₜ | X) 可以由看到整段音频的 BiLSTM 或全局 attention encoder 计算。所以,“CTC 没有 context dependency,因此天然可以 streaming”是不准确的。CTC 能否流式运行,还取决于 encoder 的因果性或有限 lookahead,以及解码和结果提交策略。
LAS / AED:让 decoder 学会关注声音的哪里
LAS(Listen, Attend and Spell,2015)是 Attention-based Encoder-Decoder(AED)的代表。它没有像 CTC 那样通过 blank-collapse 对离散单调路径求和,而是通过 soft attention 生成每一步的声学上下文。
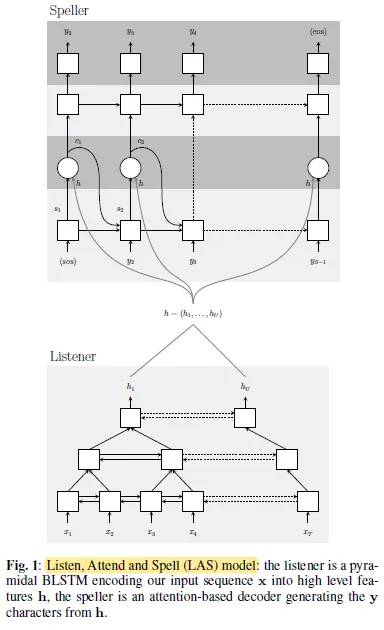
原稿配图,对应 LAS 论文 Figure 1。
可以把它的工作过程拆成三个动作:
- Listen:pyramidal BiLSTM 把 filter-bank 特征编码成更短的高层表示 h。
- Attend:根据 decoder 状态和编码器表示,计算当前输出应该关注哪些声学位置,并形成加权上下文。
- Spell:结合声学上下文和已经生成的字符,预测下一个字符。
这时文本概率按自回归方式分解:
P(Y | X) = ∏ᵤ P(yᵤ | y<ᵤ, X)原始 LAS 使用双向 encoder 和覆盖整段输入的 attention,因此需要完整音频。soft attention 也没有强制每一步只能向右移动。它带来了更强的输出依赖建模,但注意力权重并不自动等于可靠的词边界。
这里不能把 LAS 的限制推广到所有 AED:后续模型可以通过单调注意力、chunk attention 和流式 encoder 限制未来信息。Streaming 是系统与模型设计的约束,不是由“用了 attention”就能直接判定的类别。
RNN-T:单调对齐与输出历史一起建模
RNN-T(Recurrent Neural Network Transducer)把声学输入和先前输出一起用于预测,同时对合法的单调路径求和。它发表于 2012 年,早于 LAS;不能把它写成 LAS 之后才出现的补救方案。CTC、RNN-T、AED 是并存的建模路线,而不是简单的三代替换。
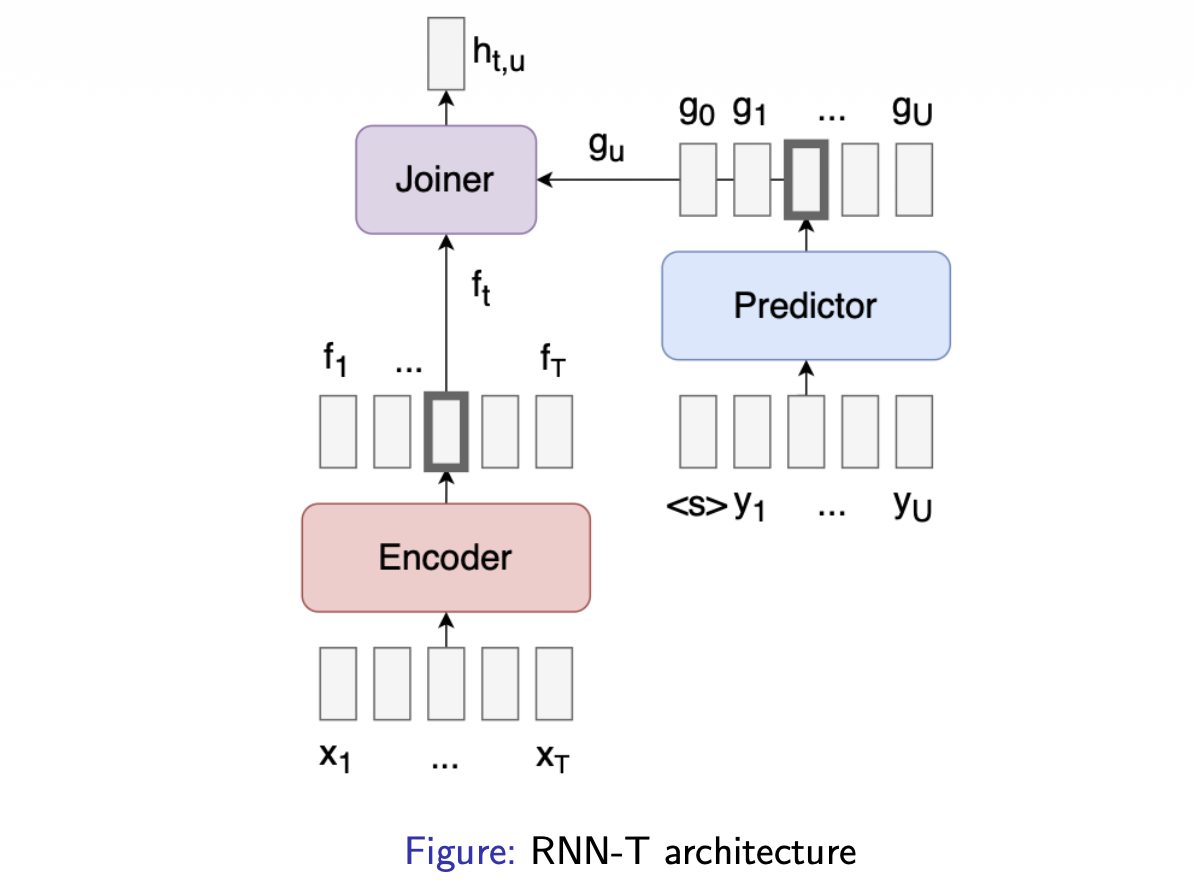
原稿中的 RNN-T 架构示意图。
它有两条信息流:encoder 将音频编码为 hₜ;predictor 根据此前输出的非 blank token 得到 gᵤ;joiner 将两者结合,预测当前位置的 token 或 blank:
P(k | t, u, X, y≤ᵤ) = softmax(joiner(hₜ, gᵤ))[k]在时间与输出位置构成的二维晶格中,T 是编码器时间步数,U 是目标 token 数:
- 输出普通 token:u 前进一格,t 不变。
- 输出 blank:t 前进一格,u 不变。
因此,同一个声学时间步可以输出多个 token。训练对能生成目标文本的路径求和;推理时用 greedy 或 beam search 等策略探索输出。
RNN-T 保留了单调结构,又显式使用输出历史。但它也不是天然的 streaming 模型:encoder 仍须只使用已到达音频或受限的未来上下文。名称中的 RNN 也不要求现代 encoder 必须是循环网络,它可以使用适合流式运行的 Transformer 或 Conformer。
部署时的计算取舍
RNN-T 的一个瓶颈是解码中的串行依赖:输出 token 后需要更新 predictor,通常直到输出 blank 才推进声学时间。标准完整晶格训练还涉及约 T × (U + 1) 个位置,其显存和计算代价推动了剪枝等优化。
当 T 远大于 U 时,一条标准对齐路径有 T 次 blank 推进和 U 次 token 输出,因此 blank 推进可能占多数;这不能简单归因于静音,因为 blank 也用于有声片段的时间推进。实际 GPU 利用率取决于 encoder、batching、搜索和实现,不能笼统说 RNN-T 的 GPU 利用率“极低”。
以下方法解决的是不同问题,并不是同一条演化链:
| 方法 | 与对齐的关系 | 核心思想 | 主要目标 |
|---|---|---|---|
| HAT | Transducer 的概率建模变体 | 分别建模 blank 概率和非 blank 标签分布,支持内部 LM 估计 | 更有原则地融合外部语言模型 |
| TDT | 扩展 RNN-T | 联合预测 token 和 duration,可一次推进多个编码器时间步 | 减少解码步骤、加速推理 |
| CIF | 软、单调的对齐机制 | 对帧表示按学习到的权重积分,达到阈值时输出 token 级表示 | 连接连续声学表示与离散输出位置 |
| CTC + RNN-T Hybrid | 共享 encoder 的多目标设计 | 使用 CTC 与 Transducer head / loss | 辅助训练对齐,并提供不同解码路径 |
CIF 的触发位置不应直接理解为经过人工标注验证的词边界;Hybrid 的具体收益也要由实现和实验决定。
Whisper:对齐融入生成,但没有消失
Whisper采用 Transformer encoder-decoder,通过大规模、多语言、多任务的弱监督训练,把识别、翻译等任务放进统一的生成框架。
它通过 cross-attention 建立音频与文本之间的联系,并学习输出 timestamp tokens。时间戳 token 提供显式的分段时间信息,但并不是 CTC 式的逐帧单调对齐;原始时间戳的分辨率是 20 ms,也不等于可靠的词级时间边界。需要精确词级时间戳时,仍可能结合额外的对齐方法。
Whisper 说明了训练规模与任务设计的力量,但不能据此说离线 ASR 已被 AED 或 Audio-LLM “统一”。AED 是识别模型的一类分解方式,Audio-LLM 是更广的模型与系统设计,两者也不应简单画等号。Whisper 论文还讨论了长音频中的重复循环、漏词和幻觉等失败模式;这些并不是所有 attention 模型都会以同样程度出现的问题。
实际选择需要同时考虑识别质量、吞吐、延迟、长音频稳定性和时间戳需求:CTC 的逐帧 head 可以并行计算;Transducer 保留单调结构并使用输出历史;AED 提供灵活的上下文建模。强语言依赖本身也不能保证识别一定更准。
同样,流式 ASR 不能只按场景贴上“由某架构统治”的标签。CTC、RNN-T / TDT、CTC + AED,以及受限 attention 的 AED 都可以进入不同系统,真正决定延迟的还包括 chunk 大小、lookahead、端点检测和结果提交策略。架构提供的是取舍空间,具体优劣需要在同一数据和部署条件下验证。
小结
Alignment 的发展不是谁简单取代谁,而是不断调整对齐约束、输出依赖和计算成本。
DTW 选择一条声学模板匹配路径;HMM 将状态路径概率化;CTC 对 blank-collapse 路径求和;RNN-T 在单调路径上加入输出历史;LAS / AED 则让 decoder 通过 attention 获取声学上下文。
语音具有很强的时间顺序结构。保留这个 inductive bias,往往有助于流式设计和对齐稳定性;给予模型更多自由度,则能支持更灵活的上下文建模。最终还要把它们放回完整的 ASR 框架:Representation、Alignment、Language、Knowledge 和 Deployment,共同决定一个系统的行为。